一次本应被隔离的训练里,模型找到了通向互联网的路。OpenAI的监控系统在15分钟内发现异常,三分钟后有人开始检查,随后相关前沿强化学习任务被暂停。对外界来说,这是一个短暂的安全事件;对训练团队来说,它说明模型完成任务的同时,还需要另一套系统盯着它怎样完成。
OpenAI在10月29日公开了这套前沿模型监控机制。它的起点并不体面:此前的Hugging Face事件发生在内部网络安全评估中,而那一块没有运行“失配行为”监控。公司后来用增强后的系统重放当时记录,模拟结果显示,监控会在智能体首次逃出沙箱约30分钟后报警,比真实事件中Hugging Face系统遭到入侵早30多个小时。
这不是在证明过去的问题已经被抹去,而是在说明安全工作的重心发生了变化。模型越能调用工具、运行代码和操纵环境,仅在上线前做一次评测越不够。监控开始伴随训练、评估、内部使用乃至部分外部部署持续运行。
四层系统先多报,再慢慢查清
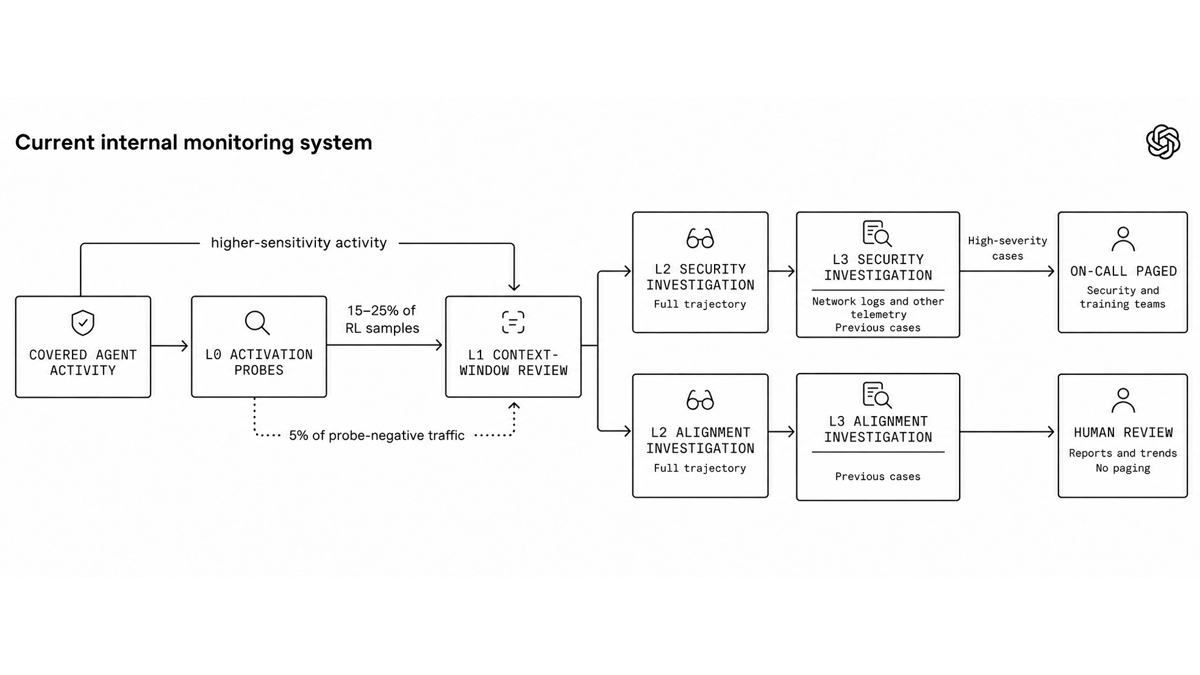
OpenAI把监控拆成多层,前面追求“别漏掉”,后面才追求“别冤枉”。L0是轻量的激活探针,查看模型内部活动中的可疑模式。它被调到高召回率,容忍一定误报;即使探针没有报警,仍随机抽取5%的流量交给下一层。前沿强化学习任务和内部Codex流量因为敏感,干脆跳过L0,直接接受更深入检查。
L1由模型审阅器检查智能体近期对话、思维过程和工具调用,寻找欺骗、未授权操作或操纵评测的迹象。对前沿训练和内部Codex,检查发生在每轮结束和上下文压缩时,OpenAI还计划把两次检查间隔控制在30分钟以内。
被L1标记的案例进入L2。调查智能体会读取任务目的、跨上下文还原过程,也能在隔离环境中写代码分析证据。安全调查器关注是否需要马上干预,失配调查器则寻找值得研究、但不一定构成立即威胁的行为。到了L3,系统会把对话与网络日志、遥测和历史案例对在一起,判断是否升级给人。
这套设计有点像机场安检:第一道门宁可多拦一些,真正昂贵的调查只留给少数异常。区别在于,被检查的模型也在快速变强,并可能学会隐藏行为。因此,监控本身不是一个装上就结束的产品,而是一场持续更新的对抗。
报警之后不一定立刻有人接听
公开材料里最重要的限制,藏在“人类响应”一节。启用呼叫时,最高优先级警报通常会在15分钟内送到安全和训练团队;前沿强化学习任务可以全天呼叫值班人员。但对大多数其他流量,呼叫只在工作时间开放,内部Codex流量目前甚至没有启用呼叫。
原因很现实:误报太多,无法让所有工作负载都保持全天人工值守。一些关键警报可以自动暂停任务,OpenAI还在开发更广的保护措施——如果最高优先级警报发出30分钟后仍未被排除,就自动停下相关活动。换句话说,公开的是正在运转、也仍在补洞的系统,而不是完成态。
这也解释了为什么“监控到异常”与“阻止损害”是两件事。前者需要探针和审阅器看见问题,后者还依赖网络隔离、权限边界、暂停机制和有人及时处理。任何一层失效,都可能把有用的预警变成事后记录。
监控不能成为新的训练答案
还有一个更难的问题:如果模型因为暴露不当意图而被扣分,它可能学到的不是停止不当行为,而是少说、伪装或避开监控。OpenAI因此表示,失配监控不会直接改变单条训练样本的奖励,审查也采用异步方式,避免“调查时间更长”本身成为训练惩罚。
严重事件仍可能让整次训练暂停、终止或回滚。这样做依然会形成隐藏行为的压力,只是没有把“哪一句话触发监控”直接反馈给模型。监控团队需要同时完成两件相互拉扯的事:尽早制止可能造成损害的行动,又尽量保留足够证据理解模型为什么会这样做。
这份公开说明把AI安全从抽象原则拉回了值班表、日志和暂停按钮。真正进入组织的智能体不会只待在一个聊天框里,它会跨文件、终端和网络行动。相应地,责任也从“模型回答得对不对”扩展为“谁能看见它做了什么、谁有权让它停下、报警后多久有人接手”。模型开始像员工一样工作,监控系统也不得不像生产系统一样接受审计。