一张建筑图纸摆在屏幕上,模型要读懂标注,再打开三维软件把它做成模型;另一边,一段动画需要逐镜检查,最后交出带时间码的修复日志。OpenAI给GPT-6.1 Terra安排的主角位置,不是陪人聊天,而是坐到电脑前把工作做完。
这款模型最醒目的变化也不是参数规模,而是价格。OpenAI给出的标准API价是每百万输入令牌1美元、缓存输入0.05美元、输出5美元,比GPT-5.6 Terra和GPT-6.1 Sol的标准价格低50%。对偶尔问一次问题的人,这个差价可能没有感觉;对每天读发票、录表格、查页面、跑成百上千个任务的团队,它直接改变一条自动化流程能不能长期运行。
降价发生在“做事”这一层
OpenAI没有把Terra描述成缩水版聊天模型。它强调的是视觉理解、电脑操作和自然写作的组合:模型既要看懂界面,也要知道下一步点哪里,还要把结果整理成可交付文本。这种组合过去往往需要把图像模型、自动化脚本和语言模型拼在一起,维护成本不只来自令牌,还来自失败后的人力接管。
官方在Agents' Last Exam上测试了建筑建模、影视逐镜检查等专业任务。中等推理强度下,GPT-6.1 Terra比GPT-5.6 Terra高15个百分点,单次成本约为后者三分之一;它的成绩接近GPT-6 Astra,而每令牌价格只有后者十分之一。最大推理强度下,OpenAI称Terra完成任务的速度超过Astra和Sol三倍。
这组比较真正改变的是模型分工。过去,团队常把最强模型放在所有步骤上,保证成功率,却不得不压缩调用量。现在更可行的做法是让Terra承担数量大、界面多、重复性高的主流程,把Sol或Astra留给最复杂的判断。OpenAI自己也保留了这条边界:在最复杂的编码任务上,Sol和Astra仍是更合适的选择。
代码能力的提升让这套分工更有说服力。Terminal-Bench 4.0考察模型能否在命令行解决真实工程问题,GPT-6.1 Terra在最大推理强度下完成50.3%的任务,而GPT-5.6 Terra公开成绩是21.5%。这不是“所有任务都能交给它”的证明,却说明低价模型与高价模型之间的能力缝隙正在缩小。
低价没有消除事实错误
OpenAI同时公布了一组更值得警惕的数据。在内部“容易诱发错误”的提示测试中,低推理强度下的事实错误率从GPT-5.6 Terra的53.6%降到16.7%;最大推理强度下则降到4.3%。降幅很大,但16.7%仍意味着把成本压到最低时,事实核验不能一并删掉。
对企业流程来说,推理强度因此不只是速度按钮,也是一种风险预算。录入格式固定的发票,可以在低强度下加规则校验;涉及合同、财务判断或对外发布的内容,就需要更高强度、结构化检查,或者交给人复核。模型更便宜之后,最容易发生的误区是把节省下来的费用理解成可以省掉监督。
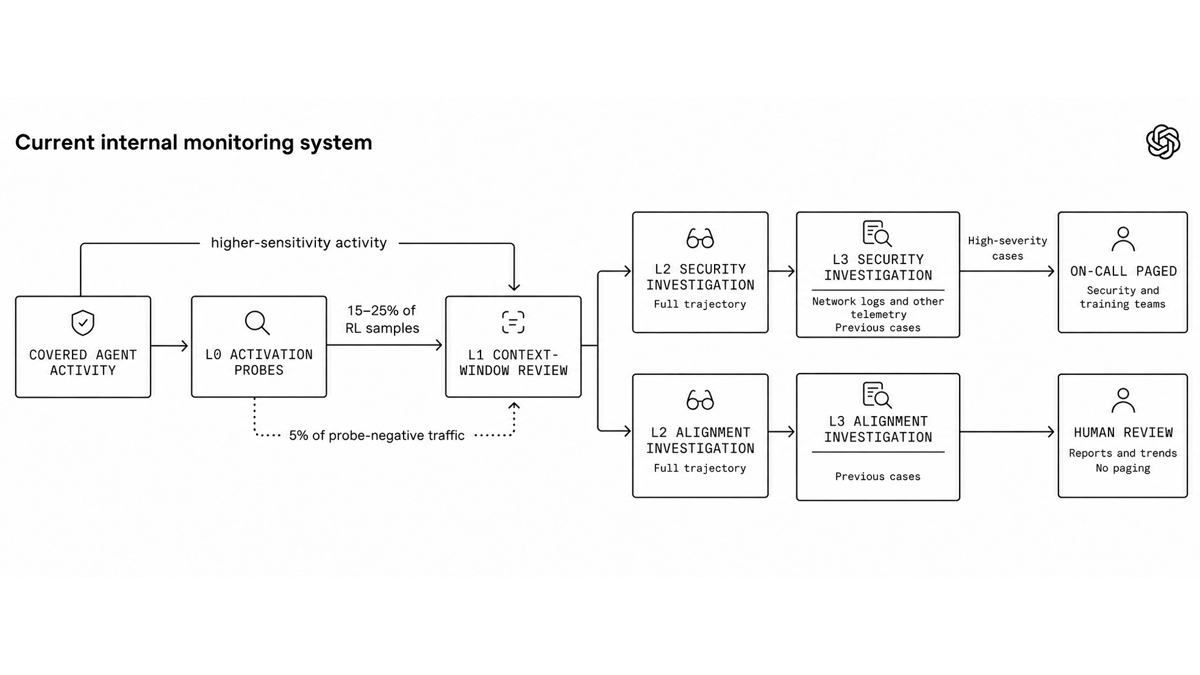
Terra还达到OpenAI准备框架中的网络安全“Critical”门槛,并沿用为GPT-6 Astra开发的保护措施。这里的含义并不是模型已经安全到可以随意接入生产系统,恰恰相反:能力越能触及真实电脑和网络,权限隔离、日志和人工接管越需要跟上。
入口被放在Work和Codex
发布路径透露了OpenAI对这款模型的定位。GPT-6.1 Terra从发布日起面向Plus、Pro、Enterprise和Edu用户开放,但入口在ChatGPT Work与Codex;开发者可以通过`gpt-6.1-terra`调用API。它不是先被推到普通聊天框里,而是先出现在带任务、文件、工具和执行过程的工作环境中。
同一订阅额度在Terra上可以完成更多任务,这让“模型选择”从排行榜问题变成运营问题。一个团队以后可能不会问哪款模型总体最强,而会问:哪一步必须用Astra,哪一步可以交给Terra,哪些结果需要人签字。价格下降把更多电脑操作带进预算,真正新增的工作却是把权限、复核和失败处理设计清楚。
GPT-6.1 Terra拉低的是执行型AI的单位成本。它没有让最强模型失去位置,却让高频的普通工作第一次有机会按流水线规模运行。新的分界线不再只是“人还是AI”,而是哪些动作可以低成本自动完成,哪些决定仍要把更贵的推理和人的责任留在场内。