紐約,2026年10月27日 / PRNewswire / -- 專注於 AI 皮膚智能和個性化護膚的 SaaS 科技公司 Haut.AI 今日發布其皮膚基礎模型 Skin Foundation Model ( SkinFM )。這是一個基於圖像的 AI 基礎模型,使用超過400萬張真實皮膚圖像訓練而成,可幫助公司更快地開發定制化的皮膚測量和分析能力。
Haut.AI 也發布了 SkinBench,這是一項新的公開基準測試。該公司表示,這項測試顯示,包括來自 Google、OpenAI 和 Anthropic 的模型在內的六個領先的 AI 模型,經常會識別出並不存在的皮膚問題,或者無法識別實際存在的問題。Haut.AI 表示,雖然流行的 AI 模型可以識別人臉並描述可見特徵,但 SkinBench 的結果表明,它們在準確評估皮膚方面可能存在困難,從而可能導致不準確的皮膚評估和推薦。
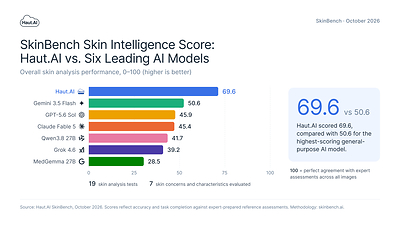
Haut.AI與六個領先的AI模型在SkinBench上的表現
在 Haut.AI 新公開的 SkinBench 基準測試中,六個領先的 AI 模型——包括 Google 的通用模型 Gemini 3.5、OpenAI 的 GPT-5.6、Sol、Anthropic 的 Claude Fable 5、xAI 的 Grok 4.6、阿里巴巴的 Qwen 3.8 27B,以及 Google 的醫學專用多模態 AI 模型 MedGemma(27B)——在約95%至100%未出現眼部浮腫的圖像中,錯誤地識別出了眼部浮腫。
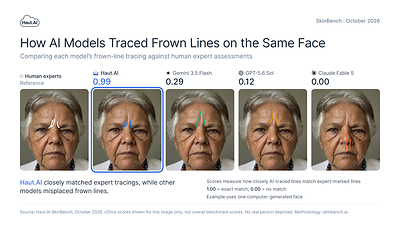
這些模型在識別皺紋和判斷膚質類型(如乾性、油性或混合性)方面表現也不佳。當被要求在臉上標出皺眉紋時,一個領先模型將鼻子和嘴巴標了出來,而另一個則在測試圖像上沒有畫出任何線條。
相比之下,Haut.AI的模型識別出了82%的深額頭皺紋,而其他模型的識別率在15%至60%之間;其平衡準確率為78%,而其他模型為37%至58%。平衡準確率對每種膚質給予同等權重。
總體而言,Haut.AI的技術在SkinBench皮膚智能評分中獲得了69.6分(滿分100分)。該評分衡量皮膚分析的準確性和任務完成度,100分代表與專家對每張圖像的評估完全一致。相比之下,得分最高的通用AI模型Gemini得分为35分,Flash得分为50.6分。
為何護膚需要專門為皮膚分析打造的 AI
隨著越來越多企業轉向使用為特定行業和任務設計的 AI,而非完全依賴領先的大型模型,這些結果也隨之出現。Gartner 在 2025 年 4 月預測,到 2027 年,企業使用小型、專用 AI 模型的頻率將至少是通用大型語言模型的三倍。
NielsenIQ 發現,49%的消費者曾經接受過生成式 AI 提供的美妝產品推薦。對這類工具的依賴正在加深:Accenture 發現,75%的美妝消費者表示願意接受 AI 驅動的購物體驗。這種開放態度也延伸到護膚領域。Haut.AI 對1238名美國女性的調查顯示,62%的美國女性對使用 AI 获取護膚或身體護理建議感興趣,或已經在使用 AI;其中一半受訪者表示,她們會信任 AI 提供的身體護理產品推薦。
Haut.AI 首席執行官兼聯合創始人 Anastasia Georgievskaya 表示:「AI 能夠識別人臉,但這並不意味著它能準確評估皮膚。我們的研究結果顯示,當今一些領先的 AI 模型經常會檢測出並不存在的皮膚問題。隨著消費者越來越依賴 AI 來獲得護膚建議,這確實令人擔憂。我們開發 SkinFM,是為了讓皮膚分析更加準確;我們創造 SkinBench,則是為了讓業界能夠看到不同 AI 模型的真正表現。」
SkinFM 的作用:面向美妝品牌的皮膚分析基礎模型
與需要為不同皮膚分析任務分別訓練模型的傳統 AI 系統不同,SkinFM 采用單一的基於圖像的 AI 基礎模型來分析多種皮膚特徵。這種方法也使 Haut.AI 能夠更快開發新的皮膚測量指標,並創建可根據不同品牌需求定制的分級體系。Haut.AI 的技術可評估230多項皮膚測量指標和48項生物標誌物,包括皺紋、泛紅、色素沉著及其他可見皮膚特徵。
對於美妝品牌而言,這意味著他們可以根據自身的產品和客戶需求定制皮膚評估,更快地推出新的測量指標,提供更有針對性的個性化推薦,追蹤隨時間變化的可見改善,並支持護膚研究和產品開發。
SkinBench 結果:六個領先的 AI 模型在皮膚分析中的表現
SkinBench 将 Haut.AI 的專用皮膚分析技術與 Gemini 3.5、GPT-5.6、Sol、Claude Fable 5、Grok 4.6、Qwen 3.8 27B 和 MedGemma 27B 進行比較。該基準由 Haut.AI 的數據科學團隊開發,圍繞七類常見皮膚問題和特徵進行19項測試:皺紋、曬斑、泛紅、膚色、肌質、黑眼圈和眼部浮腫。其中11項測試用於識別和分級可見皮膚特徵,8項測試用於衡量模型定位這些特徵的準確性。結果與專家準備的參考評估進行對比。
以下五項SkinBench發現顯示出性能差異有多大,以及這些差異為何重要:
- 專用 AI 在一項特定的皺紋評估中與人類專家最为接近。Haut.AI 在皺眉紋嚴重程度與專家評估的一致性上得分为0.82,GPT-5.6 為0.73,人類分級員的得分为0.86。基於350張計算機生成的人臉,這一結果表明,專用 AI 在某些界定明確的皮膚分析任務上可以達到與人類水平相當的一致性。
- AI 常常檢測出並不存在的皮膚問題。正如眼部浮腫的結果所示,不準確的 AI 皮膚評估可能導致不必要的產品推薦、浪費支出,並削弱消費者對美妝品牌個性化護膚服務的信心。
- 識別皺紋並不等於準確定位皺紋。當被要求在350張合成面孔上描繪皺眉紋時,Haut.AI獲得47.8分,GPT-5.6和Sol獲得20.2分,是表現最強的競爭模型。這種差異之所以重要,是因為品牌需要知道皺紋的位置,才能衡量變化並評估產品效果。
- AI 模型在肤質分類上的一致性較差。Haut.AI 在肤質分類上得分为77.8分,而表現最強的競爭模型為57.7分。錯誤識別某人的肤質可能影響保溼霜、潔面產品及其他護膚品的推薦。
- 不同肤色之間的準確性存在差異。Haut.AI在不同肤色上的表現得分为50.9分,而次優的通用AI模型的得分為30.3分。該評分聚焦於每個模型表現最弱的合格肤色群體,凸顯出品牌需要確保其技術對不同肤色的消費者都能穩定可靠。
Haut.AI並非在每一項測試中都勝出。例如,Gemini在3.5這一項上表現更好,Flash在魚尾紋評分方面表現更優(71.7分對61.8分),在肤色評估方面也更好(90.4分對87.6分)。這些結果進一步說明,在評估AI工具時,應該針對其預期執行的具體任務來進行,而不只是看單一的總分。
SkinBench的公開排行榜為不同皮膚分析能力及不同肤色上的表現提供了單獨的評分,方便企業根據自身最相關的能力來比較模型。
Haut.AI 计劃繼續擴展 SkinBench,納入更多 AI 模型,並增加新的測試,以檢驗模型在分析同一皮膚問題時是否會給出一致的结果。
Georgievskaya 表示:「隨著 AI 在美妝領域越來越普遍,品牌需要證明支撐其推薦的技術能夠提供可靠的結果。錯誤檢測不僅是技術失誤,還可能導致不恰當的產品推薦、不必要的購買,以及消費者信任的流失。我們的目標是為品牌提供所需的證據,幫助它們選擇能夠贏得並維持消費者信任的 AI 技術。」
SkinBench 排行榜、模型對比和測試方法可在 skinbench.ai 查看。
提供給新聞媒體的圖表資料
Haut.AI為報導SkinBench基準測試的新聞媒體提供配套資料,包括展示關鍵發現的圖表和詳細說明AI在特定皮膚評估中的表現的HTML報告:
- 圖表(4張):這四張圖表突出了基準測試的主要發現,包括 AI 模型在識別皮膚問題、識別皺紋、分類膚質以及評估不同膚色準確性方面的表現。
- HTML 皮膚評估示例(8份):八份詳細的 HTML 報告比較了 AI 模型在評估具體皮膚問題時的表現,包括眼下細紋、魚尾紋、黑眼圈、眼部浮腫、額頭紋、眉間紋、唇紋和晒斑。每份報告都提供了可視化對比、性能指標和詳細結果,展示不同 AI 模型之間的差異。
全部12項資源均可用於編輯用途,並可在此下載。
關於 Haut.AI
Haut.AI 是一家專注於 AI 皮膚分析和個性化護膚的技術公司。該公司由科學家和 AI 創新者共同創立,開發先進的皮膚智能技術,幫助美妝及健康品牌在不同膚色和身體部位上測量並理解皮膚特徵。Haut.AI 的技術基於超過2000萬張圖像,其專利圖像匿名化技術在保留分析所需的皮膚數據的同時,保護可識別的面部信息。Haut.AI 與 Neutrogena、Beiersdorf、Ulta Beauty、Grupo Botic 以及 rio 等全球領先品牌合作,提供以科學為基礎的個性化護膚體驗,以增強消費者參與度並推動業務增長。該公司獲得了戰略投資者的支持,包括 Ulta Beauty 旗下的 Prisma Ventures、Grupo Botic 及 rio 的風險投資部門,以及 LongeVC,並參與了 Microsoft、for、Startups 和 Google 的 Gemini Startup Forum。更多信息請訪問 haut.ai。
媒體聯絡人:Michael Tebo、Gabriel Marketing Group(代表Haut.AI),電話:571-835-8775,電子郵件:[email protected]