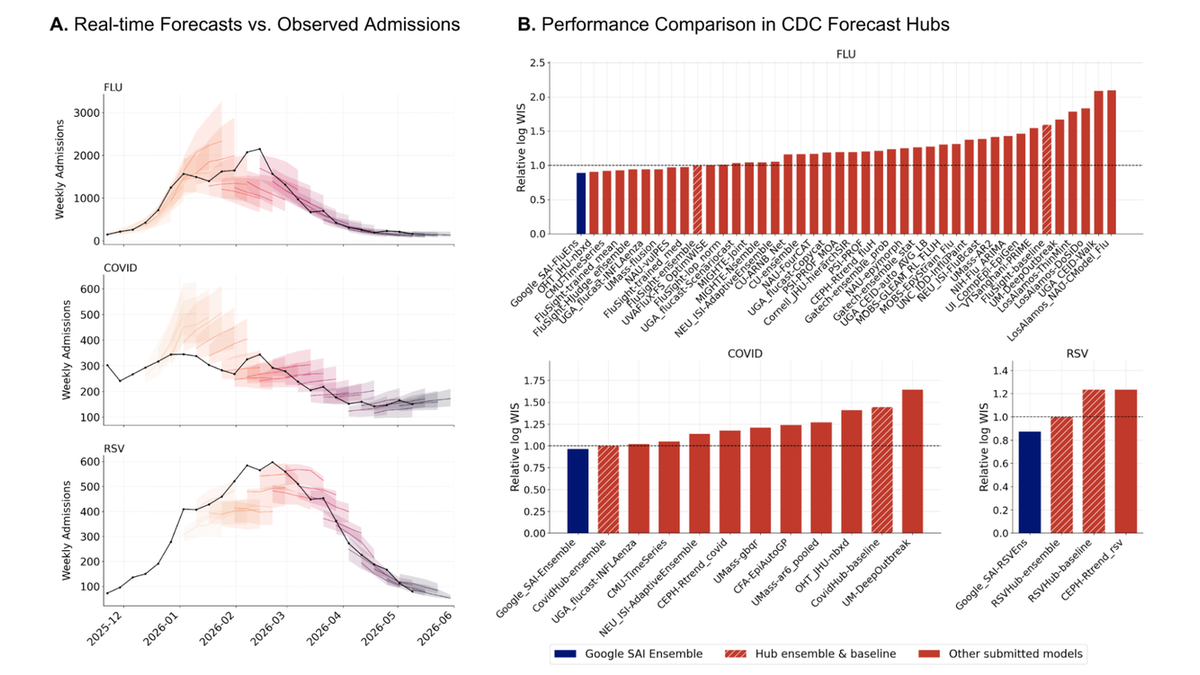


流感高峰来临前,医院最想知道的不是模型能否写出一段漂亮解释,而是未来几周会有多少人需要住院。美国疾控中心CDC近日公布2025—2026流感季预测评估,Google研究团队的一套AI模型在39个符合条件的模型中,整体最接近该季实际住院人数。Google于9月30日介绍了这一结果。它是一次真实季节、真实数据下的好成绩,但“排名第一”仍不等于任何地区、任何季节都能准确预报,更不意味着医疗资源已由AI自动调度。
CDC的FluSight项目每周接收政府、大学和企业团队提交的预测,目标包括当周及未来三周的美国流感相关住院人数。组合预测被用于向各州传达可能的医疗服务需求。要理解这次排名,就必须把它放回这个具体赛制:比较的是同一个流感季的预测与随后观察到的数据,不是对所有传染病的能力测验;领先的模型也可能在某些州、某些时间段出现明显偏差。
排名背后的技术变化,不只是“喂给模型更多数据”
Google表示,相关预测利用了其Empirical Research Assistance系统。这个工具用于生成和改进科学优化算法,相关研究已发表于《自然》,底层技术目前只向受信任测试者开放。与一般人熟悉的聊天机器人不同,这项工作核心是寻找更适合预测任务的算法和参数组合,再把结果放进可以与其他团队比较的公开评测中。它强调的是可检验的预测,而不是生成一篇看似权威的医学建议。
流感住院人数受病毒流行、人口结构、检测行为和医院收治标准共同影响。同一个模型在全国总量上表现出色,到了局部地区可能因为样本少或突发传播而不稳定。因此,公共卫生部门需要的不只是单个名次,还要看概率区间、极端高峰是否漏报、不同提前量的误差,以及结果能否及时到达决策者手中。如果预测给出“未来三周需求上升”,医院真正要安排的还有床位、人员、药品与转诊,任何一环都不是算法本身能替代的。
CDC采用多团队每周提交的方式,恰恰为模型设置了现实约束。研究团队不能只挑对自己有利的历史片段展示,也不能在看到当周结果后再补交一份“预测”。持续提交留下可比较的时间序列,坏的一周和好的一周都要算进去。这比一次静态论文图表更接近实际使用,也让外界更容易判断模型是否只是碰巧押对了一个峰值。Google此次所说的“第一”,应理解为在该季CDC评估规则下表现最好,而不是一种永久认证。
从排行榜到医院排班,中间还缺三道关
第一道关是跨季节复现。流感病毒株、接种情况和社会行为每年不同,去年的最优算法未必适合下一年。持续滚动评测比一次获奖更有说服力。第二道关是地方适用性。全国趋势掩盖了州之间的差异,而床位和医护人员在具体城市,不能凭一条全国曲线调配。第三道关是把不确定性说清楚:决策者需要知道“高峰可能提前两周”的范围,而不是只看到一个精确到个位数的预测值。
Google的公告没有给出该模型在所有州和所有预测周的误差明细,也没有表明CDC已经把它单独设为官方决策依据。FluSight本来就是多模型参与的体系,综合结果与人工流行病学判断仍重要。对外传播如果把“评测最优”写成“AI提前准确预知流感”,就把科研进展变成了过度承诺;反过来,把它看成纯实验又会低估持续预测的实用价值。
更值得关注的,是研究工具把“找到合适算法”的工作从少数专家手中扩展出来之后,能否继续留下足够透明的验证轨迹。科学预测不需要模型像医生一样发号施令,却需要它在公开规则、真实结果和反复复测面前站得住。这个赛季的成绩证明AI辅助算法设计可以进入公共卫生预测的第一梯队。它的下一场考试,是在新的流感季继续给出稳定、可解释、能被谨慎使用的预测。
若要把模型真正接进医院管理系统,还需要建立一条反向通路:预测显示住院高峰即将出现,管理者调整值班安排之后,要记录哪些决定来自模型、哪些来自临床经验,以及实际住院量与预测差了多少。只有这样,下一季才能知道模型是在改进决策,还是只是把既有直觉画成了一条曲线。公共卫生领域最忌讳的是模型得了高分却无人知道如何使用,或者一旦出错就找不到原始预测与当时的处置依据。
资料来源:Google Research,2026年9月30日;CDC FluSight季末评估。https://blog.google/innovation-and-ai/models-and-research/google-research/google-science-ai-flu-forecasts/